什么是 Skills:AI 不缺聪明,缺的是「我们这儿怎么干」
Skill(技能)是一份写给 AI 看的操作说明,放在一个文件夹里,用 Markdown 写成。它不提升模型的能力,它规定「这件事在我们这儿该怎么做」:先做什么、按什么标准判断、输出成什么格式。
一、老员工退休带走的东西
公司里最值钱的东西,往往不在系统里。
比如报销单怎么填才不会被退回、客户投诉到什么程度该升级、周报里哪三个数字是老板真正看的、合同里哪些条款必须逐字核对。这些东西写在老员工脑子里,新人只能「跟着做几遍就懂了」。
人一走,这套东西就散了。有人试过写成制度文档,但文档是给人看的,AI 读不懂「看情况处理」是什么意思。
Skill 想解决的就是这件事:把「我们这儿怎么干」写成 AI 能照着执行的说明。
区别在哪?制度文档写「要严格审核」,技能会写「第一步检查金额是否超过 5 万,超过转财务复核;第二步核对供应商在不在白名单,不在就退回」。一个是态度,一个是步骤。
二、一个技能就是一个文件夹
格式简单得出奇。一个文件夹,里面一份 SKILL.md,就成一个技能。
SKILL.md 开头是一小段元信息,两个必填项:名字和描述。名字有格式要求,小写字母、数字、连字符。描述最重要,它是模型判断「这个任务要不要用这个技能」的唯一依据。
描述写「帮助处理文档」,它永远不知道该在什么时候用。描述写「从 PDF 里提取文字和表格、填写表单、合并文档;当用户提到 PDF、表单或文档提取时使用」,它就知道什么时候该出现。
后面是正文,用 Markdown 写,把步骤、判断标准、常见错误、示例都放进去。规范建议正文控制在 5000 token、500 行以内,超了就拆到参考资料里。
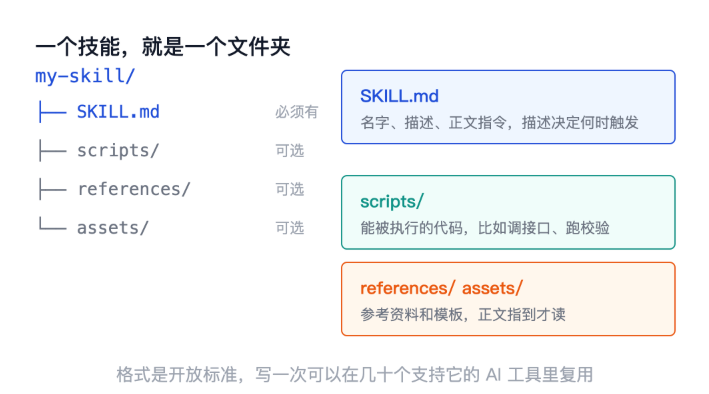
一个技能的全部结构:必须有 SKILL.md,里面是名字、描述和正文指令;可选的 scripts、references、assets 三个目录分别放可执行代码、参考资料和模板。
除了 SKILL.md,还可以带三个可选目录:scripts 放能执行的代码,references 放参考资料,assets 放模板。这三样不是必需的,但有了它们,技能能做的就不只是「告诉 AI 怎么做」,还能「直接把工具递给它」。
这套格式现在是开放标准。Anthropic 最早提出,后来被几十个 AI 工具采用,Claude Code、Cursor、Codex、GitHub Copilot、Gemini CLI 都在里面。写一次,换个工具还能用。
三、正文里到底写什么
很多人写技能,只写步骤,结果 AI 照做了还是不对——问题通常不在步骤,在缺了另外三块。
一份能用的正文,一般有这四块。触发条件:什么情况下用这个技能,什么情况下不要用。写清楚「不适用」比写「适用」更有用,它能挡住大量误触发。
步骤:编号列出来,每一步说清输入什么、输出什么。别写「处理一下数据」,要写「把日期列转成 YYYY-MM-DD,缺失的填当天」。
判断标准:什么算合格、什么要退回、什么必须找人确认。这一块最容易被漏掉,因为标准往往在老员工脑子里,不在文档里。
常见错误:踩过的坑写进去。比如「客户名称里带括号的,不要拆成两列」,这一句能省掉后面无数次返工。
四块之中,只有步骤是「怎么做」,另外三块决定了「做得对不对」。技能的质量,八成在判断标准这一块。
四、它怎么做到不占地方
这里有个矛盾:如果每个技能都是几千字的说明书,装十个就把上下文窗口占满了。
解法是分层加载,也就是常说的「渐进式披露」。
第一层,启动时。模型只读每个技能的名字和描述,一个大约 100 token。装二十个技能,也就两千 token 左右。
第二层,匹配上了。用户的话和某个描述对上了,才把那个技能的正文读进来。这时候占的是几千 token。
第三层,真用到。正文里如果指到某个脚本或参考资料,那一刻才去读。
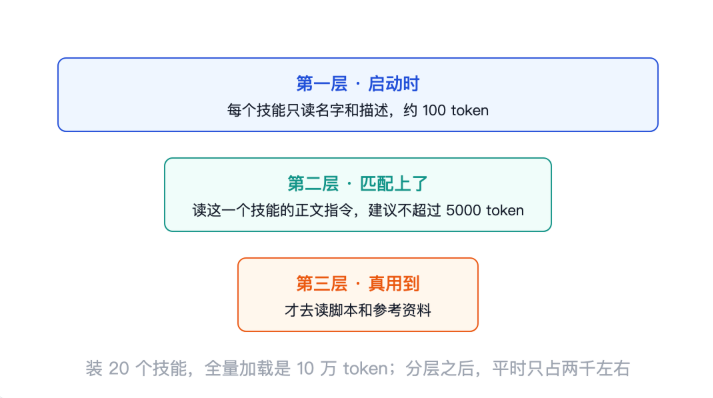
技能的三层加载机制:启动时只读简介(每个约 100 token),任务匹配后才读正文(建议不超过 5000 token),正文指向的脚本和资料只在真正需要时加载,内容越多进入上下文越少。
关键在于:大部分技能会永远停在第一层。装了二十个,一次对话可能只触发一个,其余十九个只占了两千 token 的目录费。
这也是描述为什么那么重要。它是唯一在「还没决定用不用」时就被看到的内容。描述写得含糊,技能永远不会被触发;描述写得太宽,「帮我写个邮件」也会把它叫出来。
五、它和 MCP 的分工
这两个东西经常被混在一起,其实分工很清楚。
MCP 解决「够不够得着」:AI 能不能连上你的 CRM、数据库、工单系统。
Skills 解决「知不知道该怎么干」:连上之后,按什么步骤、什么标准、什么格式来做。
打个比方:MCP 是给新同事开了门禁、发了系统账号;Skills 是那本《我们部门的工作手册》。只有门禁,他进得去但不知道从哪下手;只有手册,他知道该干什么但进不去系统。
两者可以叠起来用。技能里写「先调 CRM 查客户等级,等级是 A 的走快速通道」,前半句是 MCP 的活,后半句是 Skills 的活。
六、什么样的活适合写成技能
四个特征,占三个就值得写。
步骤相对固定。每次都是这么几步,不会大变。
有判断标准。什么叫合格、什么情况要退回、什么必须找人确认。
反复发生。一周要做三次以上,或者每个新人都要学一遍。
输出格式有要求。报告有固定结构、表格有固定字段。
反过来,一次性的任务、强依赖实时数据的任务、需要临场发挥的任务,写成技能不划算。写一个技能的成本不低,只用一次,不如直接跟 AI 说。
还有一件事容易被忽略:技能是会过期的。业务变了、系统改了、口径调了,技能得跟着改。所以它应该跟代码一样进版本管理,而不是躺在某个人的电脑里。很多团队踩过这个坑:技能写了半年,早跟实际流程对不上,AI 还在按老规矩办,而且办得又快又准。
七、三个误解
误解一:技能就是提示词。不完全。提示词是一次性的,技能是可复用的;提示词只影响这一次对话,技能会在匹配时自动加载,还能带脚本和参考资料。
误解二:技能越多越好。不对。技能多了,目录会变长,模型要在更多描述里挑,选错的概率上升。描述之间还有可能互相冲突,行为会变得不可预测。宁可少而准。
误解三:写技能是技术人员的事。恰恰相反。最该写技能的人,是那个知道「这活到底该怎么干」的业务骨干。格式很简单,会写文档就会写技能。
八、几个常被问到的问题
技能和提示词模板有什么区别?
提示词模板是你每次手动贴进去的一段话。技能是装好的,模型自己判断该不该用,用完还能调脚本。
装在哪儿,怎么触发?
不同工具放的位置不一样,常见的做法是放在项目里的 .agents/skills/ 目录,或者用户目录下的对应位置。触发靠描述,不需要你每次手动选。
会不会占很多 token?
平时不会。没被触发时只占描述那一百来个 token。真正占地方的是正文,但只有匹配上才读。
技能写错了怎么办?
先看触发率。该用的时候没用,八成是描述写得不够具体;乱触发,是描述太宽。这两个问题改描述基本能解决,不用动正文。
一个技能能调用另一个技能吗?
可以,正文里直接写另一个技能的名字就行。但别嵌太深,两层以上出问题很难排查——你不知道是哪一层的判断出了偏差。
七巧的 skills 是什么?
七巧这边有两层,容易混。
一层在平台内部:七巧 AI 的助手可以挂技能,在应用内的 AI 设计里配置,用户在对话框里选技能、发消息。这层解决的是「在七巧里怎么用 AI」。
另一层是对外:七巧把平台能力做成了 Skill 技能包和 MCP 服务,给 Codex、Claude Code、Trae、WorkBuddy、企业微信智能机器人这类 AI 产品调用,用来操作七巧的开发平台和运行平台。这层解决的是「在别的 AI 工具里怎么用七巧」。已有的七巧应用,也可以按技能的形式接进企业微信的智能助理。
一张卡片记住它
Skill(技能):一个文件夹加一份 SKILL.md,用来告诉 AI「这件事在我们这儿该怎么做」。
三个关键:描述决定触发、正文分层加载、可以带脚本和资料。
一句话:AI 不缺聪明,缺的是你们公司的干法。
- 发表于 12小时前
- 阅读 ( 7 )
- 分类:常见问题